Tesseract.js:纯 JavaScript 多语言 OCR 识别库
Tesseract.js:纯 JavaScript 多语言 OCR 识别库信息
- 系统要求:多平台(详见内容页)发布时间:2026-09-15 15:23:15
Tesseract.js:纯 JavaScript 多语言 OCR 识别库使用指南
微信扫描体验
Tesseract.js:纯 JavaScript 多语言 OCR 识别库简介
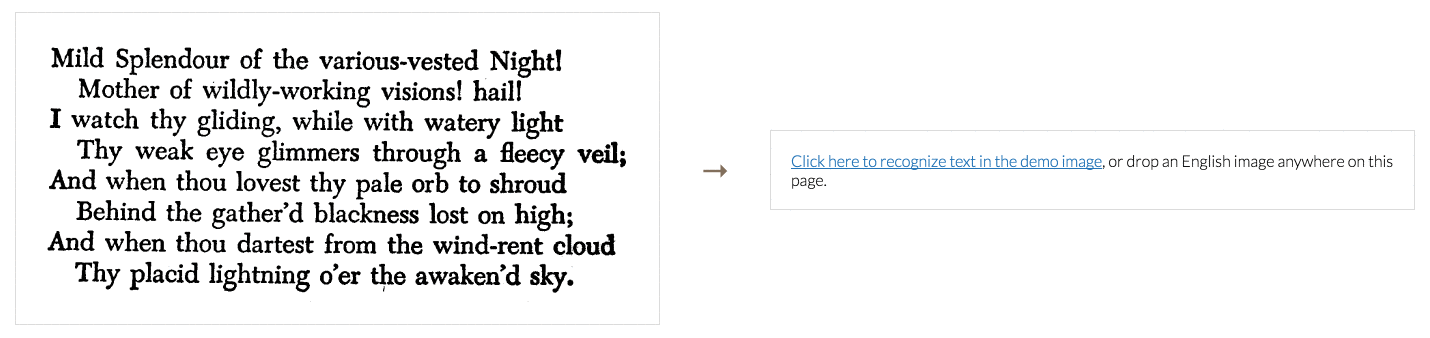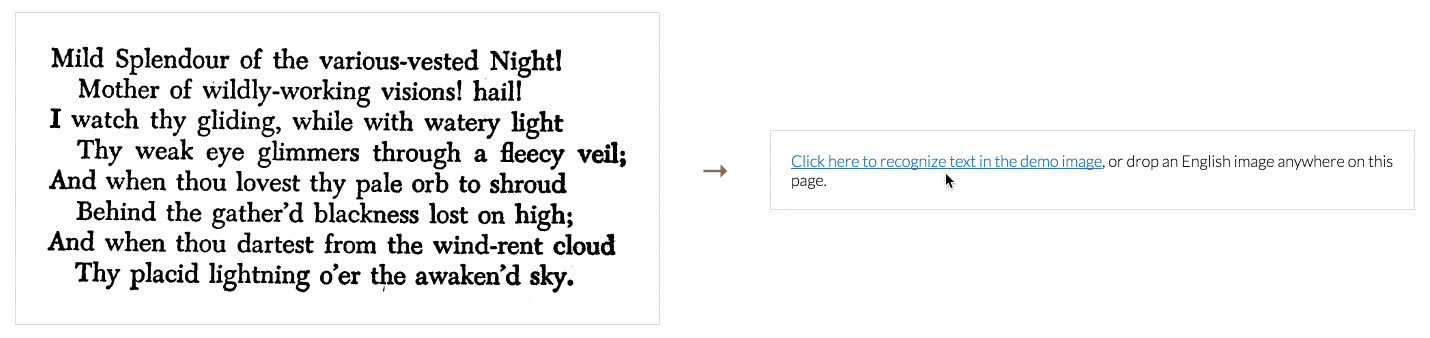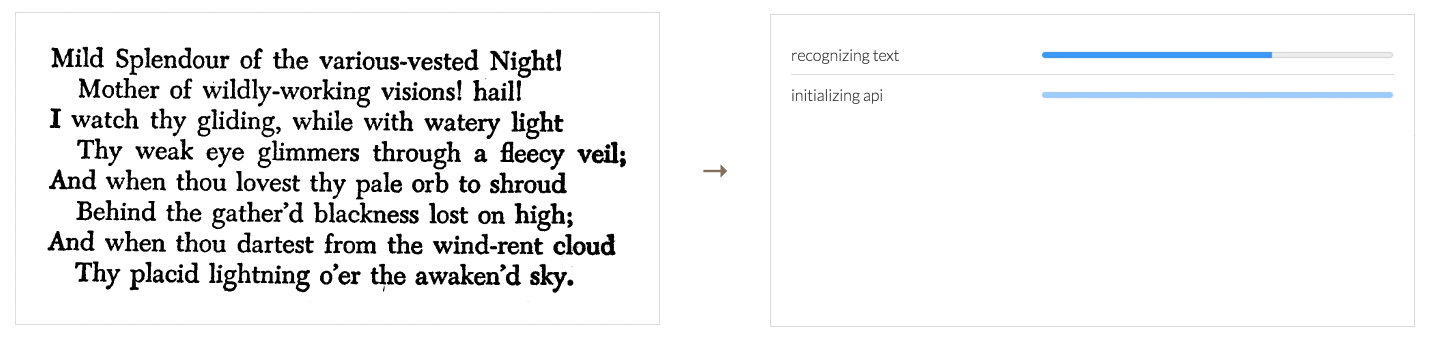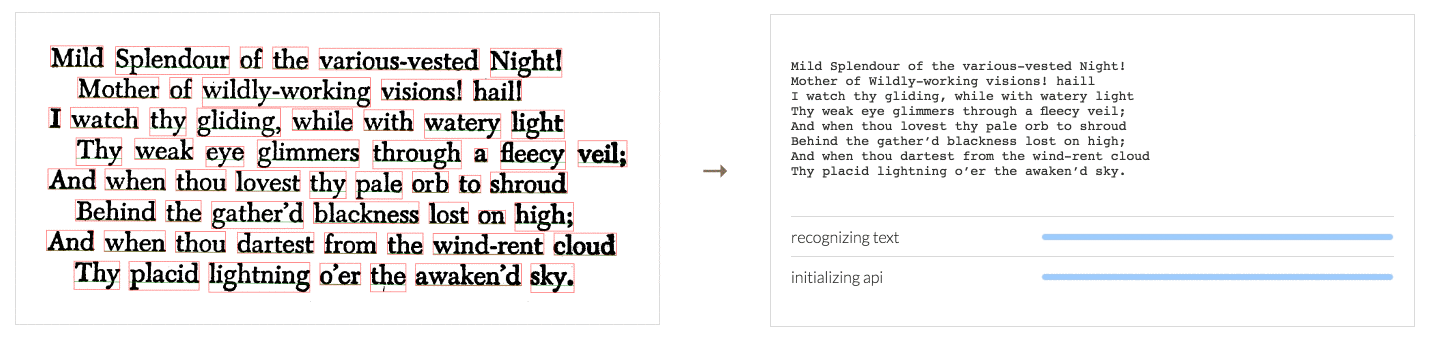
Tesseract.js 是一款纯 JavaScript 的多语言 OCR(光学字符识别)库。它借助 WebAssembly 将经典的 Tesseract OCR 引擎编译后运行在浏览器与 Node.js 环境中,无需安装任何原生依赖即可从图片中识别文字,并支持包括简体中文在内的上百种语言,让网页应用与服务端程序轻松获得离线文字识别能力。
适用平台
支持现代浏览器(可通过 script 标签、CDN、Webpack 或 ESM 方式引入)以及 Node.js 16 及以上版本的服务端环境。
安装与使用
Node.js 项目中使用 npm install tesseract.js 安装依赖;浏览器项目中可直接引入 CDN 地址获得全局 Tesseract 对象。使用时创建 worker 并调用 recognize 即可识别图片,例如:const worker = await createWorker('chi_sim'); const ret = await worker.recognize(image); console.log(ret.data.text); await worker.terminate();。语言数据文件会按需自动加载,识别多张图片时可复用同一 worker 以提高效率。
主要功能
- 图片文字识别,支持上百种语言(含简体中文 chi_sim 等),可加载多语言组合识别
- 基于 WebAssembly 运行原版 Tesseract 引擎,无需 C++ 编译与原生依赖
- 支持浏览器与 Node.js 双端运行,可结合 Worker/Scheduler 并发识别提升速度
- 内置图像预处理与旋转校正,提升复杂图片的识别准确率
- 提供文本、HOCR、词级/符号级等多种识别结果输出格式
- 官方演示站与丰富的示例代码,方便快速接入与二次开发


 百度手机卫士2026最新版本
 滔滔对讲软件手机版
 微鲸助手
 iRobot home
 微鲸助手正式版
 iRobot home中文版
 埇民通
 埇民通智慧社区
 爱废料网报价
 Vemus音乐
 零供云生鲜
 涂鸦智能
 镇雄微生活最新版
 gongju.cn 工具网
